ptIA
Portulino 350M — um modelo que usa ferramentas, treinado em T4 gratuita
Fabio 21 Sep 2026 colab, transformers, dataset, sft, dpo, tool-use, e ragNo artigo do Portulino contei o começo: Markov, RNN, nanoGPT do Karpathy e o primeiro Portulino, treinado religiosamente em T4 gratuita, 100 a 150 iterações por dia e como já havia parado de treinar ele.
Era hora de criar outro modelo.
Entretanto, eu quase desisti de treinar modelos em T4 do Colab porque após o Portulino fiz outro e fiquei 3 meses treinando até que ele estagnou em 3,0 de loss e não evoluia no val. Achei que havia chegado ao limite. E olha que 3,0 parece bom no papel — mas nos meus testes de chat ele nunca passou de um n-gram glorificado, aquele papo de Markov que repete padrão sem entender nada.
Resolvi tentar novamente. Peguei esse modelo e joguei no Claude para ver se havia algum problema, e de fato havia, o RoPE estava errado. Que raiva! Meses perdidos! Pedi para fazer outro modelo e nesse tempo o Claude e outras IAs já ficaram mais espertas e para minha surpresa quando coloquei esse modelo atual para treinar algo incrível aconteceu. Como eu não sabia quanto de batch cabia em 15G da T4 eu ia aumentando até chegar no limite da memória. Pois então … enquanto os modelos anteriores só aguentavam 11 de batch esse modelo remodelado pelo Claude aguentava 21 de batch size!!!
21?? Só podia ter algo errado, não é possível! Eu joguei o modelo em todas as IAs para auditar e todas me disseram que estava correto o modelo.
Ok, então vamos treinar para ver se está certo mesmo. Logo pensei que 21 de batch demoraria uma eternidade para fazer um batch, mas não, a velocidade era a mesma dos 11 de batch do modelo anterior. Cético quanto a esse modelo deixei ele treinando até chegar nos 3,5 de loss que é quando de fato se consegue perceber alguma inteligibilidade. E foi que ele chegou em 3,5 em aproximadamente 3k iterações … Não é possível tanto ganho de eficiência! Animadissimo, rodava o validator.py para checar o val, a perplexidade e o top-1 e percebia que de fato eles estavam caindo e a cada checkpoint que eu testava no chat percebia que estava treinando muito bem.
Nesse modelo joguei fora quase tudo e recomecei do zero: vocabulário novo de 32k (cabe em 16 bits, economiza Drive) com diversos tokens especiais como <|think|>, <|RAG|>, <|json|> e <|ai|>, arquitetura reescrita (GQA com 16 heads de query e 4 de chave-valor, RoPE, RMSNorm, SwiGLU, sem bias) e por volta de 350M de parâmetros (o Portulino tinha só 280M). Contexto de 1024, AdamW, batch_size 21 na T4 e 75 na A100 com 8 de acumulação.
O regime continua o mesmo: todo dia um pouco de T4 gratuita, e de vez em quando uns créditos para A100 ou L4 darem um salto. Cada rodada de A100 troca o bloco de textos corridos — estou no segundo bloco, o terceiro vai ser CulturaX misturado pt-BR e inglês.
Os números de hoje — e repare que o treino continua rodando, isso aqui é foto em movimento, não retrato final: 12.705 iterações, uns 7,8 bilhões de tokens vistos, val_loss de 4,22 para 2,0 e top-1 de 0,32 para 0,60. Curva monotônica, sem platô.
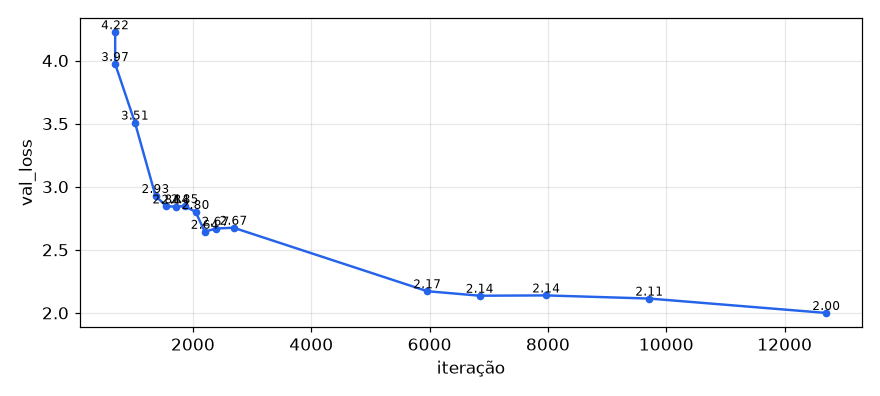
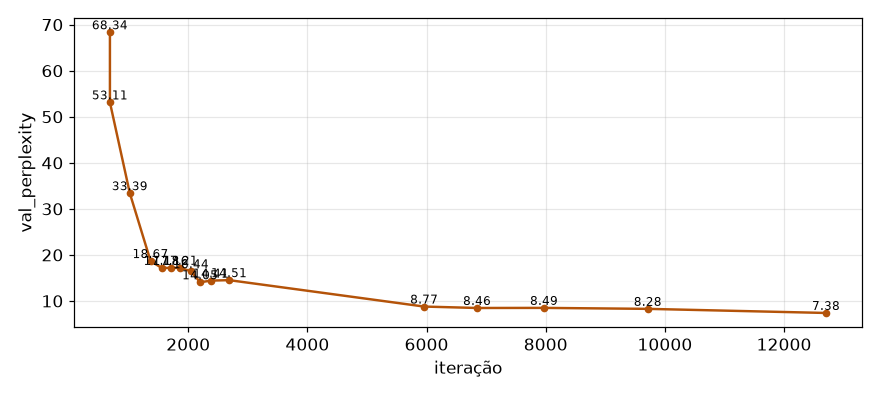
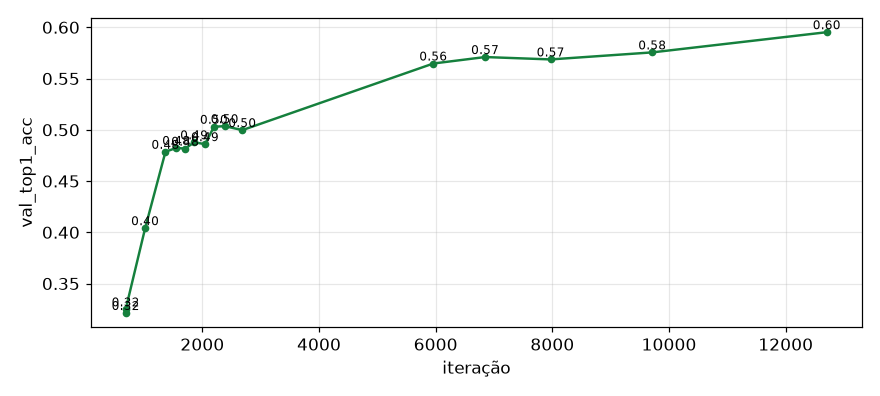
Observe no gráfico os dois saltos que duas cotas de A100 fizeram. Os pequenos saltos foram trocas de dataset e formatos. Antes eu usava um json verboso que consumia tokens e fazia o modelo penar para escrever corretamente, simplifiquei-o deixando menor. Outra mudança foram os códigos python executados; antes eles eram executados quando o modelo emitia um json shell que executava o python3 com o conteúdo do programa, extremamente burocrático, e como eu tinha o token especial <|code|> sem função utilizei-o como container de código python3 para o modelo emitir e o backend executar.
Para um modelo desse tamanho, treinado assim, está dentro do esperado — e é aí que mora a primeira lição: ele ainda está em pré-treino puro, com algo como 1% de instruct no meio. Ele nunca foi ensinado a ser assistente. Cobrar boas respostas dele agora é como cobrar de um aluno que só leu a biblioteca e nunca fez uma prova.
Em vez de só texto corrido, o dataset tem quase 400 mil blocos de diálogo num formato próprio, com marcadores para cada papel: <|user|> para você, <|ai|> para o que o modelo já disse, <|answer|> para a resposta atual, <|think|> para o raciocínio, <|json|> para chamar ferramentas (shell, search, create_file) e <|RAG|> para o resultado que volta do mundo real.
E tem um app local em Flask onde o modelo realmente executa: roda comando no terminal, pesquisa na web, cria arquivo. Quando pergunto “quais USBs estão conectados?”, ele roda lsusb de verdade e lê a saída de verdade. Quando o diretório está vazio, o ls retorna total 0 — e eu já aprendi que o erro quase nunca está na ferramenta, e sim na interpretação que o modelo faz dela.
Já que o blog promete falhas catastróficas ocasionais, vai a coleção da semana:
cat ~/Users dez vezes seguidas, falhando todas, sem nunca responder a pergunta. Discutindo esses logs com assistentes de IA, a conclusão foi simples e um pouco embaraçosa: faltava um guardrail besta — parar no terceiro erro repetido. Não é problema de treino, é de runtime, e se resolve com dez linhas.Nada disso me desanima. Cada defeito virou ou um exemplo curado à mão (RAG real preservado, resposta reescrita) ou um gate no pipeline: validador de <|json|>, quarentena de tool quebrada, filtro de conteúdo no SFT. O dataset se defende sozinho hoje.
Teve uma fase em que percebi um problema embaraçoso: meu modelo aprendia o formato do RAG mas com conteúdo inventado, porque parte dos dados de treino tinha busca simulada. Decidi então que dado de ferramenta só entra se o RAG for real — executado de verdade na hora de gerar o exemplo. Nasceram os datasets programáticos, cada um com seu gerador:
<|code|> roda, a saída vira <|RAG|>, e a resposta cita o número que saiu. Sem essa ponte, o modelo aprende a fingir que calculou.Cada exemplo sai no formato que o modelo vai ver ao vivo: pergunta, <|think|>, chamada <|json|>, <|RAG|> com o resultado real, think curto citando o dado, resposta. Nada de busca de mentira. Quando o dado não existe (arquivo sumido, diretório vazio), o exemplo ensina a dizer “não achei” em vez de inventar — a frase mais difícil para um modelo pequeno.
O próximo passo já está desenhado no notebook — desenhado a quatro mãos, minhas e de IAs com quem debato esses problemas: mistura por porcentagem — cada micro-step sorteia entre pré-treino, SFT e DPO. O SFT usa máscara -1 em tudo que é observação (user, RAG, system) e treina só o comportamento do assistente. O DPO usa pares chosen/rejected com modelo de referência congelado. Os dados já saem do pipeline em parquet com metadados no schema: tokens, labels mascarados e a spec da máscara carimbada junto, para ninguém treinar no arquivo errado daqui a seis meses.
Lição que fica desta fase, e essa eu divido o crédito: modelo pequeno aprende formato muito antes de aprender juízo. Com 1% de instruct ele já emite <|think|>, <|json|>, <|RAG|> nos lugares certos — e erra feio o conteúdo. Eu entrei nessa fase achando que dataset era tudo (ainda acho), e saí entendendo que o formato vem do pré-treino mas o juízo vai ter que vir do SFT. Metade disso eu percebi sozinho regando as plantas; a outra metade me explicaram — inclusive inteligências artificiais, o que tem sua ironia: estou usando IAs para aprender a fazer uma IA.
Uma T4 gratuita por dia, uns R$ 58 de vez em quando para A100, um Colab, e anos regando essas plantas. Sou uma pessoa só, o modelo é prova de conceito — e chegar até aqui, com pipeline completo do tokenizer ao app com ferramentas, já é a vitória. Vou continuar regando essas plantas para ver onde chego.
MAIS ARTIGOS